GENSHI AI、100万件超の日本語医療QAデータセット「GENSHI-MedQA-1M」を公開。日本語テキストの医療QAとして世界最大規模
独自に収集した日本語の医療文書 約18万ページから構築。日本語テキストの医療QAとして世界最大クラスのデータセットを公開。
株式会社GENSHI AI(本社:東京都千代田区、代表取締役:長嶋 大地)は、日本語の医療QAデータセット「GENSHI-MedQA-1M」を、公開しました。
独自に収集した日本語の医療文書 約18万ページをもとに構築した、100万件(1,005,231件)の質問と回答からなるデータセットです。公開されている日本語のテキスト医療QAデータセットとしては最大規模です(当社調べ)。
日本語の医療AIに足りなかった学習データ
大規模言語モデル(LLM)を医療で使うには、日本の診療に即した知識を日本語で学ばせる必要があります。ところが、公開されている日本語の医療QAデータセットは、医師国家試験の過去問題をもとにした数千問規模のベンチマークや、英語のデータセットを機械翻訳したものが中心でした。翻訳データで最も大きいものでも、約52万件でした(当社調べ)。
英語のデータを訳しても、日本の保険適用や薬の承認状況、国内の診療慣行の知識が足りません。臨床で使う医療AIには、日本語の原文から作った学習データが欠かせません。
「GENSHI-MedQA-1M」の概要
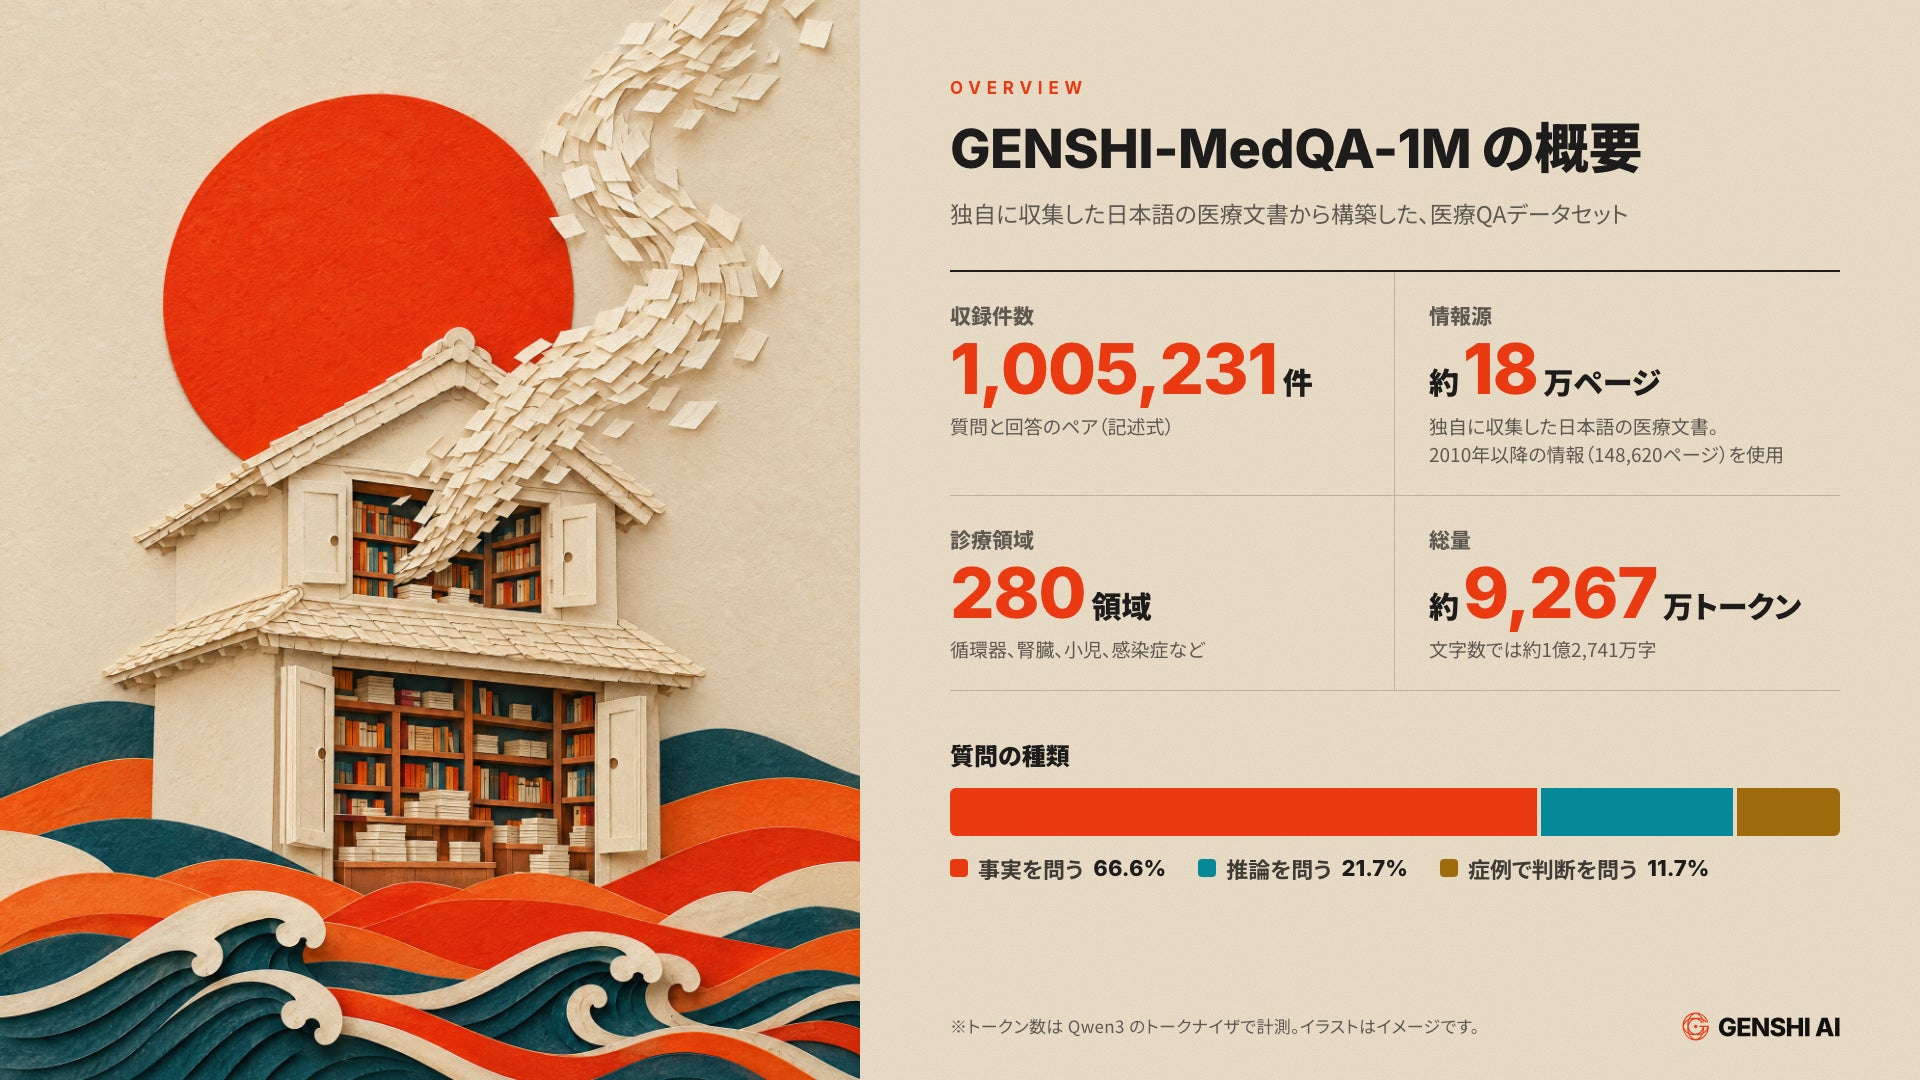
GENSHI-MedQA-1Mは、独自に収集した日本語の医療文書をもとに、生成AIで合成した質問と回答のデータセットです。2010年より前の情報は内容が古いため対象から外し、各QAは情報源の記述に基づいて作成しています。
-
収録件数:1,005,231件(約1億2,741万字、約9,267万トークン)
-
情報源:独自に収集した日本語の医療文書 179,479ページのうち、2010年以降の情報(148,620ページ)
-
質問の種類:事実を問う質問(66.6%)、推論を問う質問(21.7%)、症例を示して判断を問う質問(11.7%)
-
形式:質問と回答の記述式(1行1組)
-
公開先:https://huggingface.co/datasets/genshiai-daichi/GENSHI-MedQA-1M
収録データの例
データセットのページに掲載しているサンプルから、 2組を抜粋します。

|
質問 |
回答 |
|
尿路結石を合併する高尿酸血症の治療において、第一選択となる薬剤とその理由は? |
尿酸生成抑制薬が第一選択である。尿路結石の危険因子の一つに尿中尿酸排泄量の増加があるため、尿酸生成を抑えることで結石の形成を抑制できる。具体的にはアロプリノール、フェブキソスタット、トピロキソスタットなどのキサンチン酸化還元酵素(XOR)阻害薬が使用される。 |
|
正常成人と比較した妊婦の生理的な循環動態の変化について述べよ。 |
最大で50%程度の循環血液量の増加、末梢血管抵抗の低下、および心拍出量の増大が生じる。また、増大した子宮によって下大静脈や骨盤内静脈が圧排されるため、部分的な静脈圧の亢進および浮腫が生じる。 |
上記の通り、臨床的事実や、その背景にある病態生理・治療選択の根拠までを、日本語の記述式で収録しています。
日本語テキストの医療QAとして最大規模
公開されている日本語のテキスト医療QAデータセットのなかで、GENSHI-MedQA-1Mは最大規模です(2026年10月12日時点、当社調べ)。
次に大きいデータセット(英語の医療QAの機械翻訳、約52万件)の約1.9倍にあたります。海外を含めても、100万件を超える医療QAデータセットの公開例は多くありません。

比較の対象は、Hugging Faceで公開されているデータセットと、論文やプレスリリースで発表されたデータセットです。比較の詳細はデータセットのページに掲載しています。
下記に、既存データセットとの比較を表にまとめました。
|
データセット |
件数 |
構築方法 |
形式 |
|
GENSHI-MedQA-1M |
1,005,231 |
独自収集した日本語医療文書から LLM で合成 |
記述式 |
|
ApolloCorpus-ja5 |
24,827 |
英語の医学論文QA(ApolloCorpus)を機械翻訳 |
指示応答 |
|
JMedBench の medmcqa_jp |
187,005 |
英語の MedMCQA を GPT-4 で翻訳 |
4択 |
|
JMedEthicBench |
58,473 |
医療倫理と安全性に関する多ターン対話 |
対話 |
|
JP-AlpaCare-MedInstruct-52k |
51,992 |
英語の MedInstruct-52k を GPT-4o で翻訳 |
指示応答 |
|
JPMedReason |
32,682 |
英語の MedReason を GPT-4o で翻訳 |
推論つきQA |
|
Medical-o1-Reasoning-SFT-Japanese |
19,688 |
英語の medical-o1-reasoning-SFT を GPT-4o-mini で翻訳 |
推論つきQA |
|
KokushiMD-10 |
11,588 |
日本の医療系国家試験10種 |
選択式 |
利用条件と申請方法
GENSHI-MedQA-1Mは、非商用の研究目的に限り無償でご利用いただけます。Hugging Faceのデータセットページからお申し込みいただき、当社で内容を確認のうえ承認します。
-
対象:大学・研究機関、医療機関、企業の研究開発部門などでの非商用の研究
-
ライセンス:CC BY-NC-SA 4.0(営利目的の利用はできません。営利目的のモデル学習も含みます)
-
申請方法:データセットのページで、氏名、所属、利用目的などをご入力ください
-
申請ページ:https://huggingface.co/datasets/genshiai-daichi/GENSHI-MedQA-1M

本データセットは生成AIで合成したもので、人手による全件の検証は行っていません。
診断や治療の判断、患者さまへの助言には使用しないでください。商用でのご利用や共同研究については、当社までお問い合わせください。
代表取締役 長嶋 大地 コメント
日本語で医療AIをつくろうとすると、最初に突き当たるのが学習データの壁です。英語では大規模な医療データセットが次々に公開されていますが、日本語では国家試験の問題や、英語データの翻訳がほとんどでした。翻訳では、日本の保険診療や薬の承認状況といった、臨床で本当に知りたいところが抜け落ちてしまいます。
GENSHI AIは、自社の医療AIを開発するために、日本語の医療情報を集め、学習データを整えてきました。今回、そのうち100万件を超えるQAを、研究に使っていただける形で公開します。
日本の医療AI研究が一段前に進むきっかけになればうれしく思います。実際に使ってみたご感想や、データの誤りのご指摘も、ぜひお寄せください。
今後の展開
研究者の皆様からいただいたご意見をもとに、誤りの修正や収録内容の見直しを続け、データセットを改訂していきます。あわせて、本データセットを自社の医療AI(閉域LLM基盤「MedLocal」など)の開発にも活用していきます。
大学・研究機関や医療機関との共同研究も歓迎します。本データセットを使った研究のご相談は、下記のお問い合わせ先までお寄せください。
株式会社GENSHI AIについて
医師とエンジニアで、病院で使うAIをつくる医療AIスタートアップです。
医療機関向けの閉域LLM基盤「MedLocal」、医師向けエビデンス検索「CHUBEN」、医療用語に強い音声認識「GENSHI Voice」を開発しています。
-
会社名:株式会社GENSHI AI(GENSHI AI Inc.)
-
代表者:代表取締役 長嶋 大地
-
所在地:〒101-0024 東京都千代田区神田和泉町1番地6-16 ヤマトビル405
-
設立:2025年11月
※「国内最大規模」「最大規模」は、2026年10月12日時点で当社が調査した、公開されている日本語のテキスト医療QAデータセットの件数に基づきます(画像を含むマルチモーダルデータを除く)。
※トークン数は、Qwen3のトークナイザで計測した値です。
※記載の会社名・製品名は各社の商標または登録商標です。
本件に関するお問い合わせ先
-
株式会社GENSHI AI 広報担当
-
メールアドレス:contact@genshi.ai
-
お問い合わせフォーム:https://genshi.ai/#contact
すべての画像