1日2000体のエージェントを指揮する。Fuga v2 - Ryusei限定リリース開始
最新GPT-6 Astra/Sol/Luna、Opus 5.5、Grok 4.7、Gemini 3.8 flash対応。1ヶ月の半自動RSIで稼動エージェント数倍増・転送効率77,100%向上。
株式会社KandaQuantum(本社:東京都千代田区)は、AIエージェントの群れ(スウォーム)を計画・実行・統合まで一貫して指揮するオーケストレーター『Fuga』の新版『Fuga v2 - Ryusei』を、2026年9月23日より限定リリースします。
前回発表(Fuga v1、2026年8月29日)以降の約1か月、当社はFugaの開発そのものをFugaに任せ、エージェントを指揮する基盤を作り直しました。その結果、1日あたり2,000体超のエージェント(前回比で倍増)を安定して指揮できるようになり、1日あたりの仕事量(※1)は約10倍になりました。あわせて、指揮系統の転送効率は77,100%向上、画面への反映は7,700%高速化しています。
これは、Fugaが自らのボトルネックを見つけて直す、半自動のRSI(Recursive Self-Improvement、再帰的自己改善)ループを1か月回し続けた成果です。
1. 最新モデルに即日対応、難易度に応じて自動で割り当て
v2 - Ryuseiは、OpenAI GPT-6 Astra / GPT-6 Sol / GPT-6 Luna、Anthropic Claude Opus 5.5、xAI Grok 4.7、Google Gemini 3.8 flash に対応しました。Fugaは各タスクの難易度を見積もり、それに見合う能力のモデルを割り当てます。高難度の設計・統合には上位モデルを、定型の実装や調査には高速・低コストのモデルを使い分けることで、1日2,000体規模でもコストが体数に比例して膨らまないようにしています。
図2は、エージェントの配分設定画面です。ベンダーごとの目標割合を円グラフのドラッグまたは数値で指定すると、Fugaはタスクに必要な能力を満たす利用可能なエージェントの中から、この比率に沿って割り当てます。プールから外したベンダーの割合は、残りのベンダーに比率どおり配分し直されます。
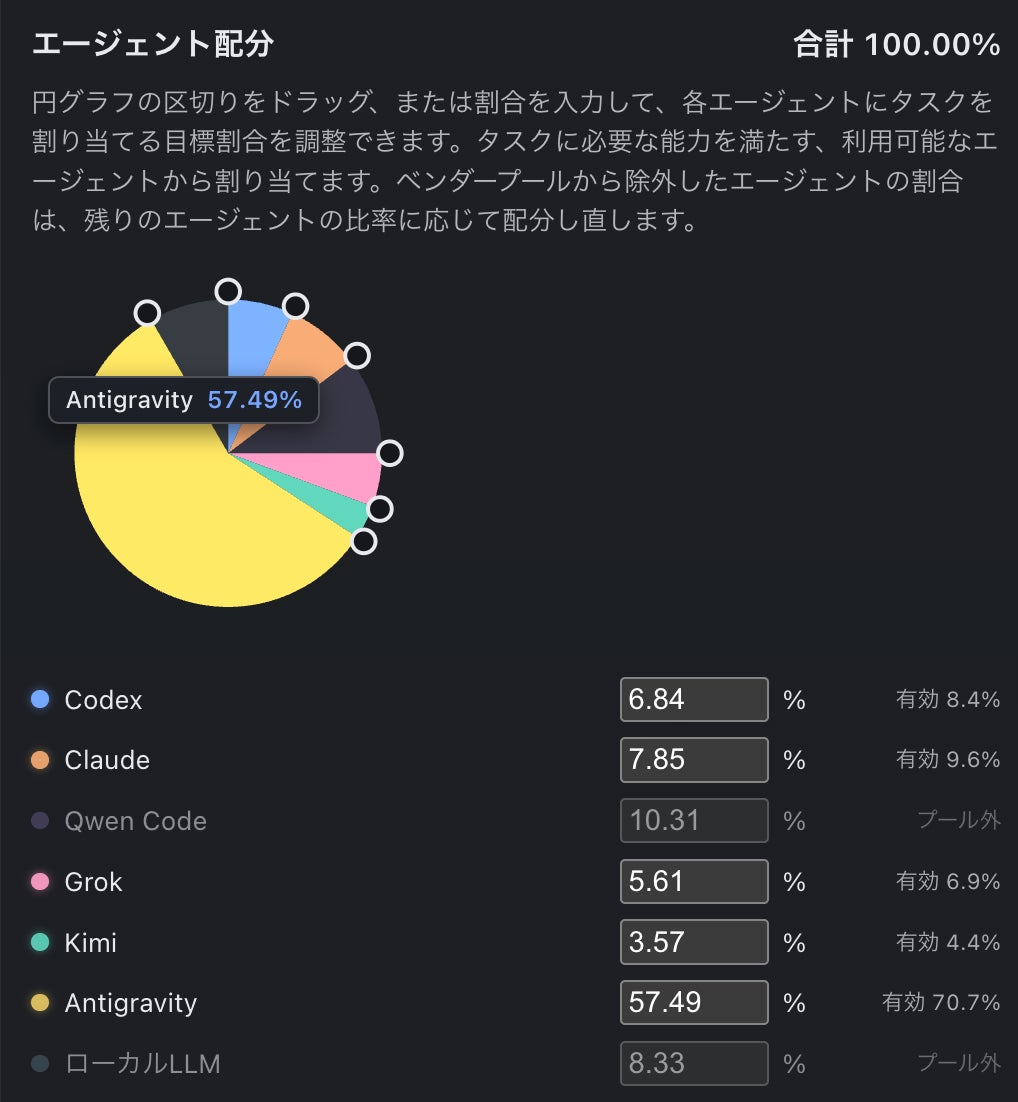
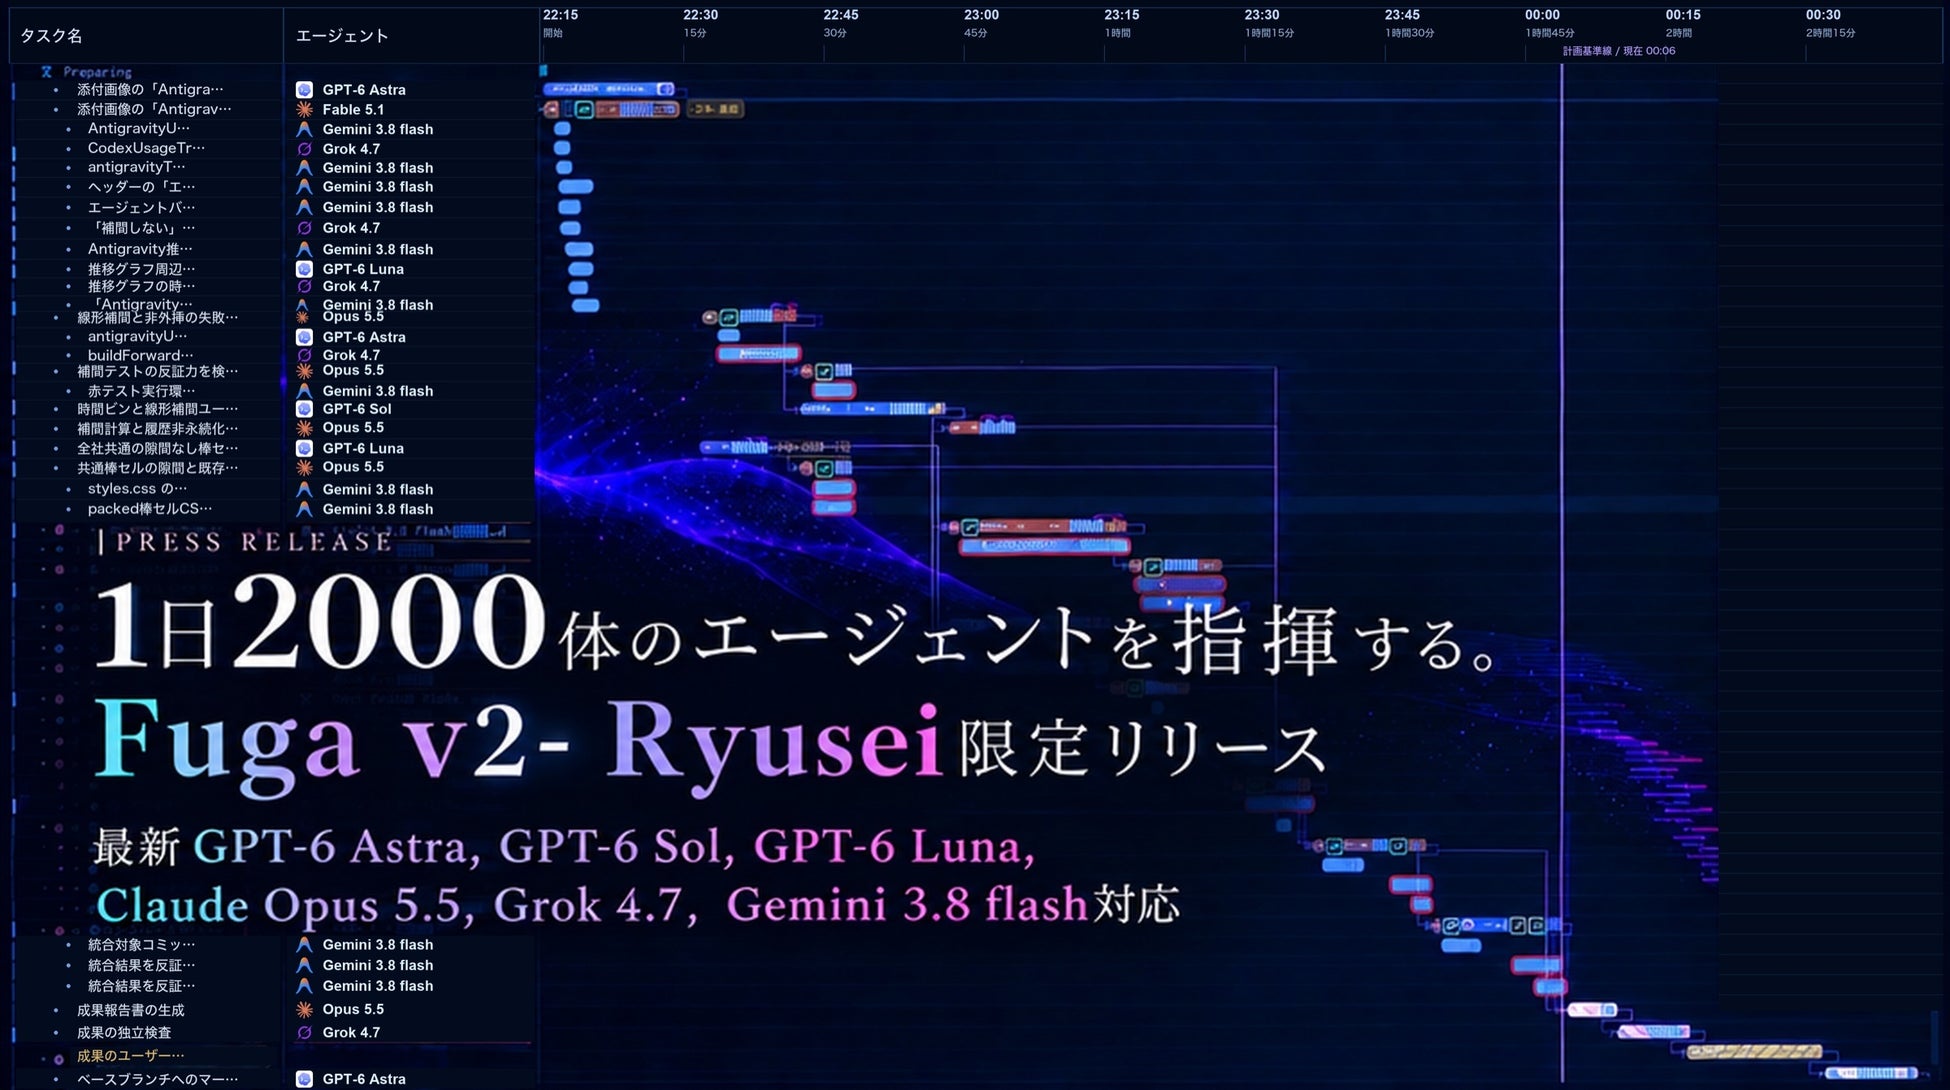
図1の実行計画画面では、ひとつの開発依頼の中で複数社のモデルが役割を分担し、計画 → 並列実装 → 統合 → 成果報告書の生成 → 独立検査 → ベースブランチへのマージ、までを一連で進めている様子が確認できます。
2. 質と量のトレードオフを越えた、2つのブレイクスルー
前回のリリース(Fuga v1)で当社は、1,285体のスウォームを安定稼働させたことを報告しました。しかしその先に立ちはだかったのが、量(体数)と質(コストパフォーマンス)のトレードオフです。体数を増やすと1体あたりの成果が落ち、成果の質を上げようとすると体数を絞らざるを得ない。この両立こそが、最も難しい課題でした。
この課題に取り組むには、まずエージェントの動員数(量)だけでなく、動員したエージェントがどれだけ成果を上げたか(質)を測る指標が必要でした。当社は、動員数を「量」、コストあたりの完了タスク数(コストパフォーマンス)を「質」、その積を「仕事量」とする指標を構築し(※1)、量と質を縦軸・横軸にとった2次元グラフで日々の状態を可視化しました。
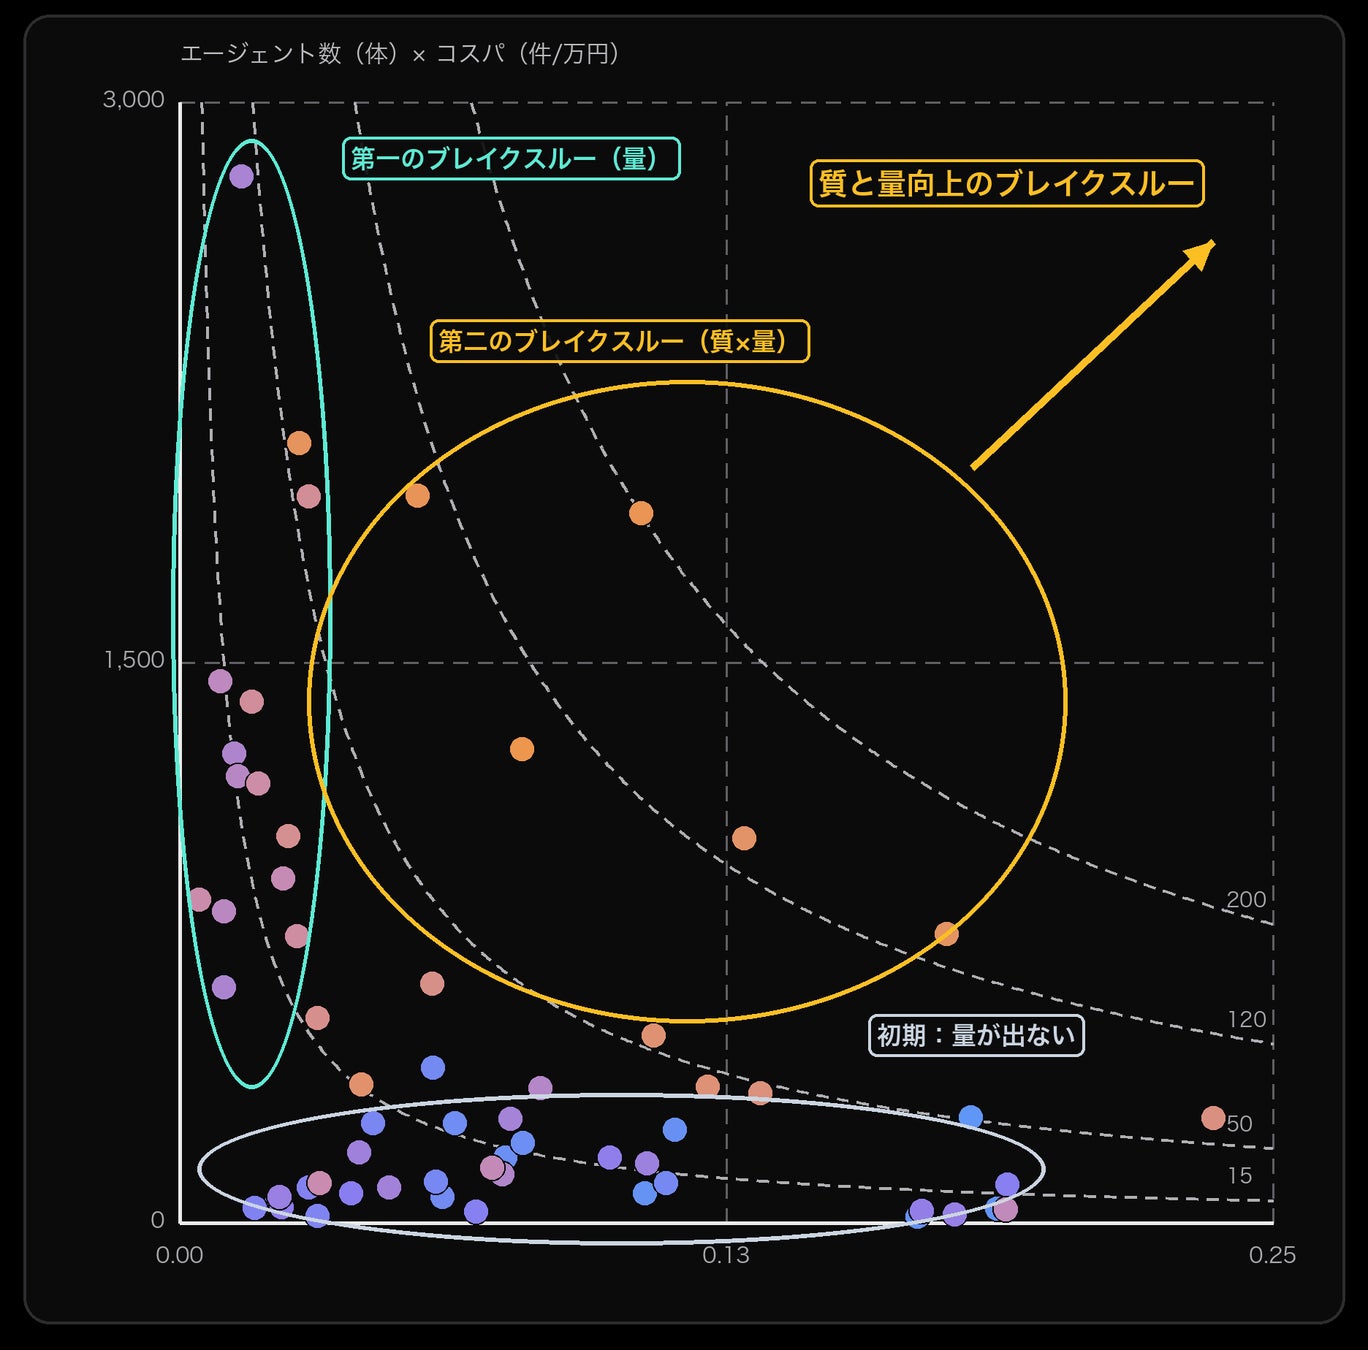
図3は、FugaがFuga自身を改善する際に駆動したエージェント数(日別)とコストパフォーマンスの関係です。初期は体数を増やせず、グラフの下側に張り付いていました。前回発表のFuga v1は第一のブレイクスルー(量)で、1,000体を超える規模を動かせるようになりましたが、この段階では逆にコストパフォーマンスが低く、グラフの左側に張り付いています。
Fuga v2 - Ryuseiは第二のブレイクスルー(質×量)の両立を実現しました。量を保ったまま質を引き上げ、グラフの右上へと抜け出した結果、1日あたりの仕事量は約10倍に増大しました。ここでいう仕事量は、その日に駆動したエージェント数(量)と、コストパフォーマンス(質=完了タスク数÷稼働コスト)の積で定義しています(※1)。
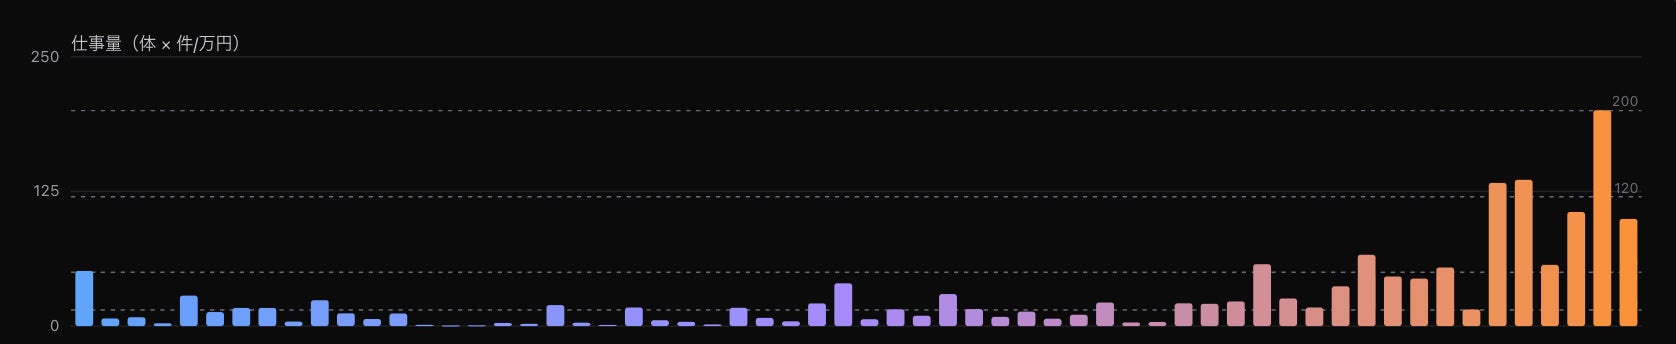
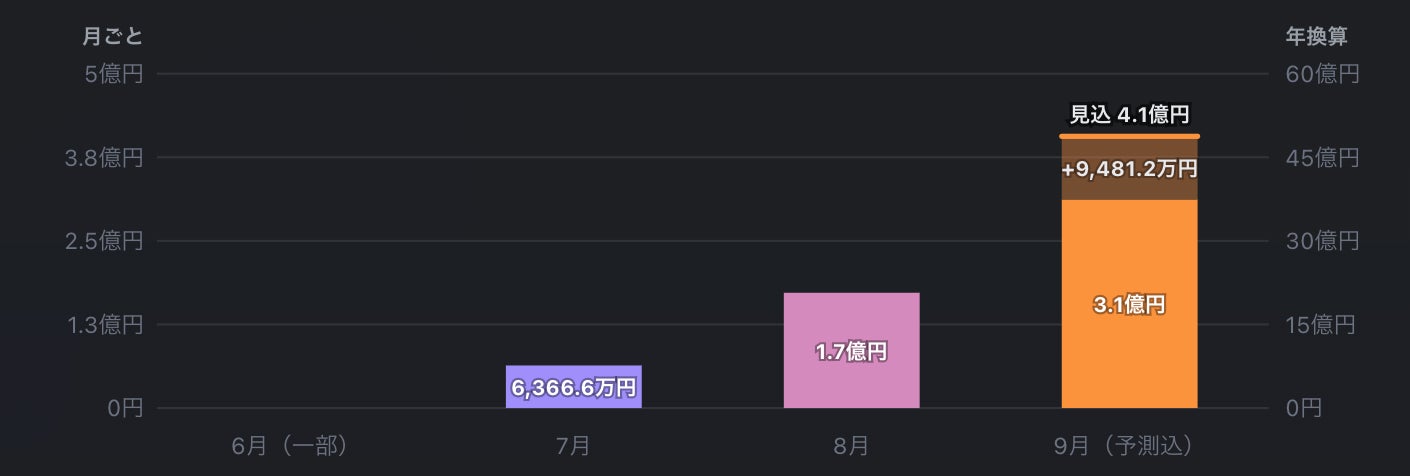
Fugaが自身の改善のために稼働させたAIの作業量を人件費に換算すると、7月の約6,367万円から、8月は約1.7億円、9月は見込みで約4.1億円に達します(図5)。
3. 半自動のRSI(再帰的自己改善):Fugaが自らのボトルネックを見つけ、自ら直す
Fugaは自分自身のボトルネックを稼働ログから検証し、改善すべき点をTo-Doタスクとして並べます。そして1つ1つのTo-Doタスクごとに20〜100体のエージェントからなる組織を呼び出し、調査・実装・テスト・統合までを進めていきました。
当初は、どのTo-Doに着手するか、成果を取り込むかといった判断の多くを人が担っていました。しかしループを回すたびにFuga自身が判断できる範囲が広がり、最終段階では成果報告書の確認や取り込みの判断までをオーケストレーターが担う、ほぼ完全に自律したループへと移行しています。こうして半自動から自律へと進化していったRSI(Recursive Self-Improvement:再帰的自己改善)ループを1か月回し続けた結果、以下の改善がFuga自身の手で実装されました(数値はいずれも社内実測)。
処理速度
-
転送効率:77,100%向上(計画AI出力の重複送信を根絶、転送量99.9%削減)
-
画面反映の遅延:最大778秒 → 秒単位(7,700%高速化)
-
承認から着地まで:5分の停滞 → 15秒(1,900%高速化)。直近71件中57件(80%)は承認1回でベースブランチへの統合まで自動で完走
-
計画AIの応答:中央値129秒 → 51秒(153%高速化)
-
配信の滞留:21,895件 → 定常0件、通信の確認タイムアウト:39件 → 0件
-
CI(事前検査):22分21秒 → 5分30秒(75%短縮)
耐障害性
-
画面プロセスのクラッシュ・30秒の無応答・通信断のいずれからも自動復旧。走行中のタスクは維持
-
通信タイムアウトの回復ループ:5.7万回 → 0回
-
アプリを終了(Command+Q)しても、中断したエージェントは次回起動時に同じ会話から作業を再開
-
ワーカー起動の失敗率:10.1% → 1.9%(81%削減)
メモリ・ディスク
-
状態ファイル:159MB → 54MB(66%削減)、1セッションあたりのrun記録:154KB → 17.5KB(89%削減)
-
高負荷時のメモリ増分:44〜91%削減。
提供形態
『Fuga v2 - Ryusei』は、KAMUI SaaS プラットフォーム上でクローズド・リリース(限定提供)として提供します。
注釈
※1 仕事量・コストパフォーマンスの定義:量=その日にFugaが自身の改善のために駆動したエージェント数(体)。質=コストパフォーマンス(件/万円)=その日に完了したタスク数 ÷ その日の稼働コスト(万円)。稼働コストは人件費換算(概算)で、AI実稼働時間×25万円/hとして算出しています。これはモデルやエージェントごとの能力差を反映した個別の単価ではなく、すべてのAI稼働時間に一律の単価を掛けた概算値です。25万円/hという単価は、人月単価160万円(月160時間稼働として1時間あたり1万円)のエンジニアに対し、AIの1時間の稼働が約25倍の実装速度に相当すると仮定した、当社の暫定係数です。25倍という倍率は、前回発表(Fuga v1)で示した「1日の稼働で約8〜15人月(約1,280〜2,400人時)相当の開発」、すなわち稼働1時間あたり約53〜100人時相当という結果を、保守的に見積もったものです。仕事量=量(体)× 質(件/万円)。「体数が多いだけ」でも「効率が良いだけ」でも大きくならず、多くのエージェントを効率よく働かせた日ほど大きくなる指標として当社が定義したものです。集計期間は2026年7月19日〜9月22日(稼働60日)。
なお、本リリースで用いた人件費換算の単価(25万円/h)、コストパフォーマンス、仕事量は、いずれも暫定的な数値です。これらは確定した評価ではなく、エージェント群の成果をより精密に測定していくための叩き台として提示するものです。特に質の評価は、完了したタスクを種類や難易度に関係なく一律に1件と数える粗い評価であり、本来はタスクの種類(調査・実装・統合など)や難易度に応じて重みを付けて集計すべきです。今後はこうした加重評価や実測にもとづく単価の精緻化を進め、指標を改善していきます。
※2 エージェント1体:独立した実行単位として起動したLLMインスタンス1つを1体と数えます(前回リリースと同じ定義)。
このプレスリリースには、メディア関係者向けの情報があります
メディアユーザー登録を行うと、企業担当者の連絡先や、イベント・記者会見の情報など様々な特記情報を閲覧できます。※内容はプレスリリースにより異なります。
すべての画像