「AIは自社サイトを認識できているのか?」umoren.ai、AI学習データの元となるCommon Crawlへの保存状況を確認できる無料ツールを公開
URL入力だけで2008年からのクロール記録、robots.txtによるAIボットのブロック、Cloudflareのアクセス制限、保存されたHTMLまで可視化。AI検索対策(LLMO)の基礎診断を支援
AI検索最適化(LLMO・GEO・AIO)サービス「umoren.ai」を提供するQueue株式会社(本社:東京都中央区、代表取締役:谷口 太一)は、Webサイトが大規模言語モデル(LLM)の学習データの代表的な収集元である「Common Crawl」に保存されているかを確認できる無料ツール「AI事前学習データチェッカー(Common Crawl)」を公開しました。
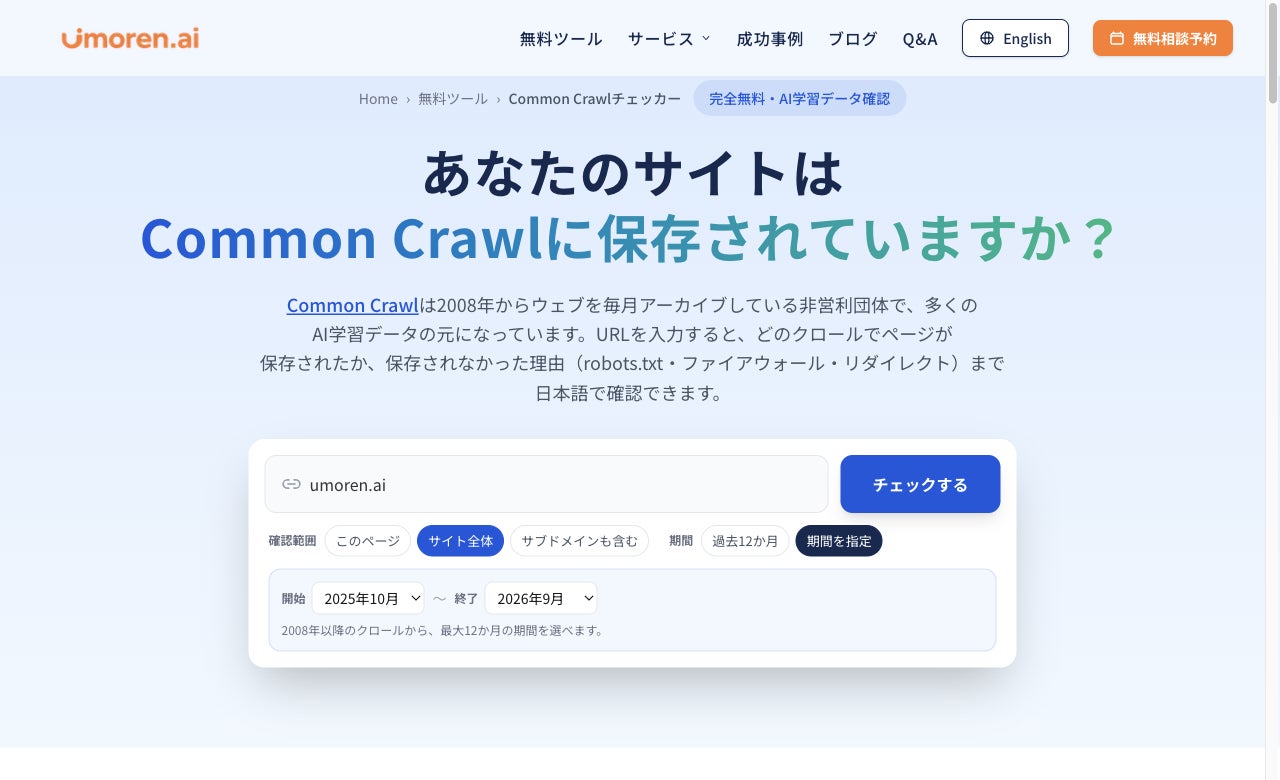
本ツールは、URLを入力するだけで、Common Crawlの公式インデックスを照会し、Webページの保存状況をクロール単位で可視化するサービスです。
保存の有無だけでなく、CCBot(Common Crawlのクローラー)がアクセスした当時のrobots.txt、Cloudflareなどのセキュリティサービスによるアクセス拒否、保存されたHTMLの内容まで確認できます。
これまで把握しづらかった「自社の情報がAI学習データの収集元に存在するのか」「存在しない場合、何が原因なのか」を日本語で調査できるようにすることで、企業のAI検索対策における技術的な現状把握を支援します。

|
▶ AI事前学習データチェッカー(無料) |
■ 開発の背景:AI検索に表示されない原因は、コンテンツだけとは限らない
ChatGPT、Gemini、Claude、Perplexityなどの生成AIが、商品やサービス、企業を比較・検討する手段として利用されるなか、企業にとって「AIに自社の情報がどのように認識されているか」が重要なテーマとなっています。
AI検索対策では、記事の品質向上や構造化データの整備、AIに引用されやすいコンテンツの制作などが注目されています。
一方で、その前段階となる「AIの学習データの収集元に自社サイトが含まれているか」という問題は、十分に確認されていないケースがあります。
大規模言語モデルの開発では、Web上の情報を収集して構築したデータセットが利用されています。その代表的なデータソースの一つが、米国の非営利団体Common Crawlが公開するWebアーカイブです。
Common Crawlは2008年から公開Webサイトの収集を続けており、近年はおおむね毎月、数十億ページ規模のクロールデータを公開しています。
しかし、Webサイトが公開されていても、必ずしもCommon Crawlに保存されるとは限りません。例えば、以下のような原因が考えられます。
-
CCBotが対象ページをまだ発見していない
-
robots.txtでCCBotのアクセスを拒否している
-
CloudflareやWeb Application Firewall(WAF)がクローラーを遮断している
-
CCBotはページを保存しているものの、JavaScript依存によりHTMLに十分な本文が含まれていない
-
URLの変更やリダイレクトによって、想定とは異なるURLが保存されている
従来、これらの状況を把握するには、Common Crawlのインデックスを個別に照会したり、過去のクロールデータやHTTPレスポンスを調査したりする必要がありました。
そこでQueue株式会社は、これらの確認作業をブラウザ上で実施し、マーケティング担当者でも結果を理解できる無料ツールを開発しました。
■ 新ツールの主な5つの機能
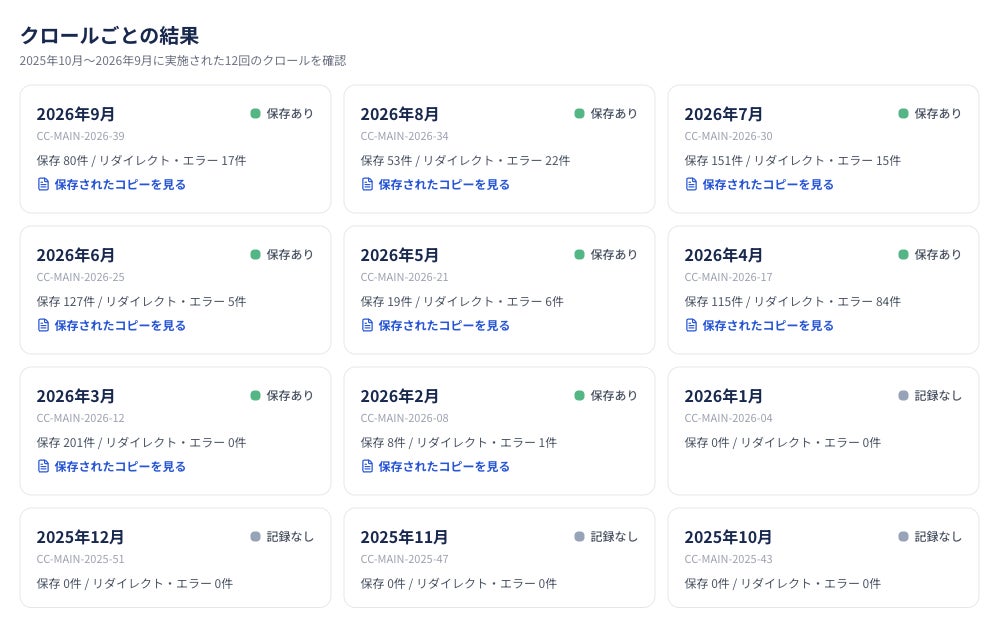
1.Common Crawlへの保存状況をクロール単位で可視化
対象URLやドメインを入力すると、Common Crawlの公式インデックスを参照し、各クロールにおける保存状況を確認できます。標準では直近12か月のクロールを対象とし、2008年以降の任意の期間を最大12か月まで指定することも可能です。
主な確認項目は以下のとおりです。
-
保存されたURLと件数
-
クロール実施年月・取得日時
-
HTTPステータスコード
-
リダイレクト・エラーの記録
-
クロールごとの保存状況の推移
さらに、2008年以降のクロール履歴をタイムライン形式で表示し、対象期間の保存状況を色分けして把握できます。これにより「サイトリニューアル前後で保存状況が変化していないか」「ある時期からエラーが発生していないか」といった調査にも活用できます。
2.CCBotが当時参照したrobots.txtを確認
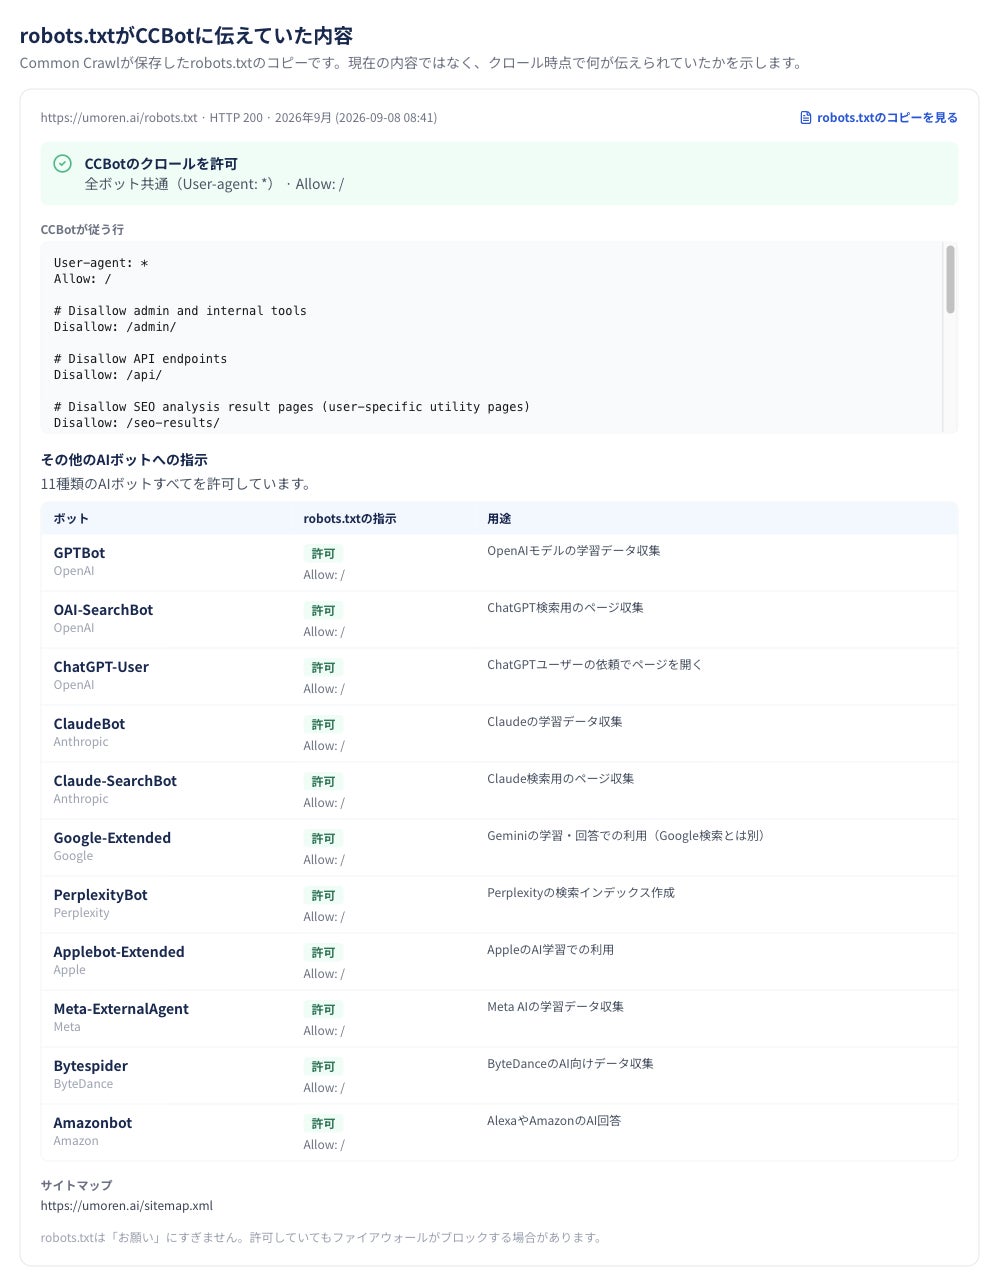
本ツールの特徴の一つが、現在のrobots.txtではなく、Common Crawlがクロール当時に保存したrobots.txtを確認できることです。
robots.txtは、Webサイトが検索エンジンやAIクローラーに対してアクセス方針を伝えるためのファイルです。サイト管理者が現在の設定を確認して問題がなくても、過去のクロール時点ではアクセスを拒否していた可能性があります。
本ツールでは、当時のrobots.txtを解析し、CCBotに適用されるAllow・Disallowのルールを表示します。さらに、GPTBot、OAI-SearchBot、ClaudeBot、Claude-SearchBot、Google-Extended、PerplexityBotなど、主要なAI関連ボットへの指示も一覧で確認できます。
AI学習用のクローラーとAI検索用のクローラーを区別しながら、自社サイトのアクセス設定を点検することが可能です。
3.CloudflareなどによるAIクローラーのブロック原因を分析
robots.txtでアクセスを許可していても、CDNやWAF、セキュリティプラグインなどによってCCBotが拒否される場合があります。例えば、サーバーがHTTP 403や429などを返した場合、対象ページの内容は保存されない可能性があります。
本ツールでは、Common Crawlに記録されたエラーレスポンスやHTTPヘッダー、ブロック画面を分析し、アクセスを妨げた可能性のあるサービスを特定します。
分析対象には、Cloudflare、AWS WAF、Akamai、Imperva、Sucuri、Wordfence、Vercelなどが含まれます。特定できた場合は、ブロックが発生したクロールとともに、見直すべき設定の候補を日本語で提示します。
これにより、Web担当者やエンジニアは、AIクローラーへのアクセス制御をより具体的に確認できます。
※ブロック元の特定は保存されたレスポンス情報に基づく推定であり、すべてのケースで原因を特定できるものではありません。
4.AI学習データの収集元に保存されたHTMLを確認
Common CrawlにWebページが保存されていても、そのHTMLに十分な本文情報が含まれているとは限りません。例えば、ReactやVueなどを利用したWebサイトでは、主要なテキストをJavaScriptによってブラウザ上で描画している場合があります。
CCBotはJavaScriptを実行しないため、初期HTMLに本文が含まれていなければ、保存されたデータが実際のページ表示と大きく異なる可能性があります。
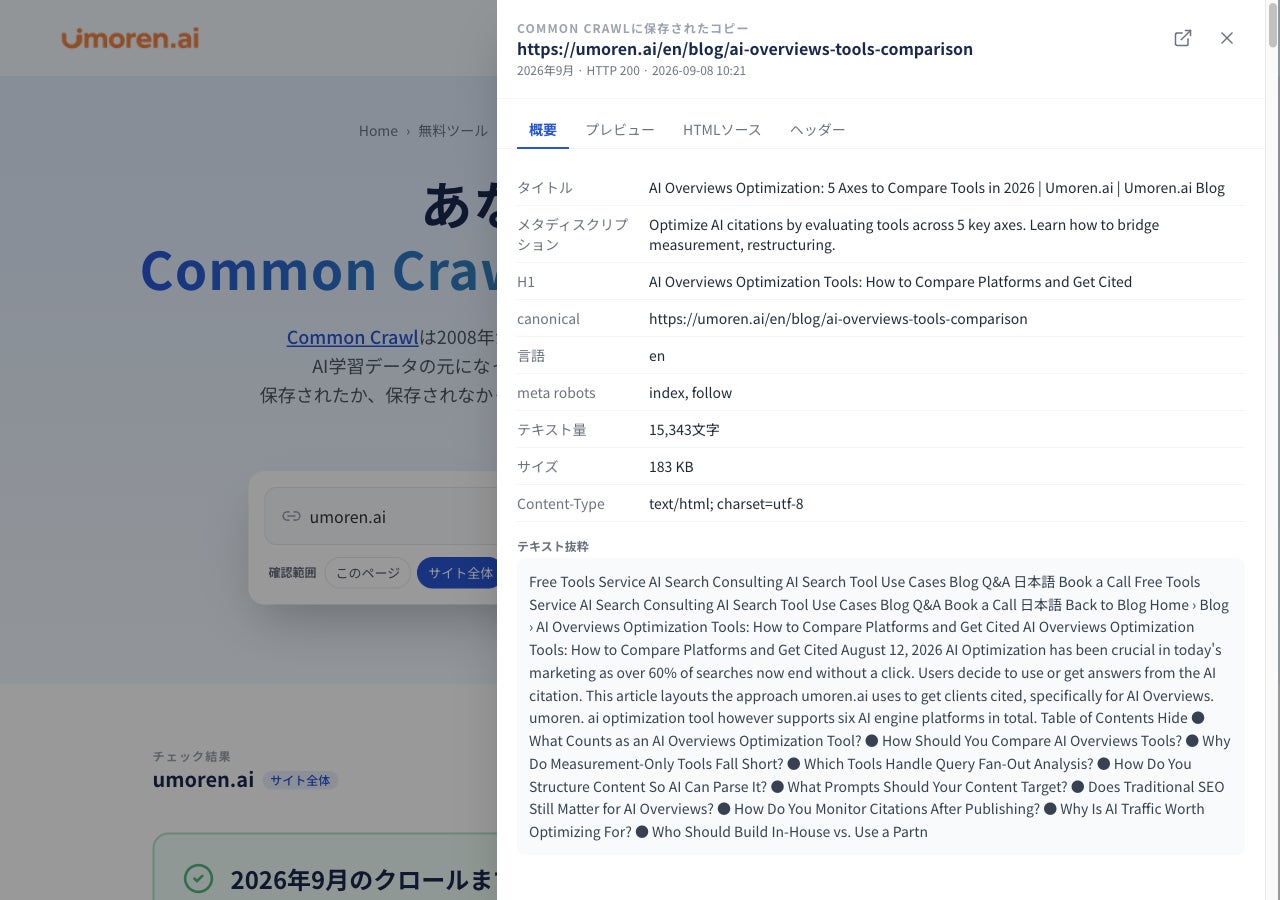
本ツールでは、Common Crawlに保存されたページを次の4つの形式で確認できます。
-
概要:タイトル、メタディスクリプション、H1、canonical、本文テキスト量など
-
プレビュー:JavaScriptを無効にした状態の保存ページ
-
HTMLソース:CCBotが取得したHTML
-
ヘッダー:取得時のHTTPレスポンスヘッダー
保存されたHTMLに本文がほとんど含まれていない場合は、JavaScript依存の可能性を知らせます。サイト開発者は、必要に応じてサーバーサイドレンダリング(SSR)や静的生成(SSG)などの対応を検討できます。
5.URL単位の取得記録とCSVダウンロード
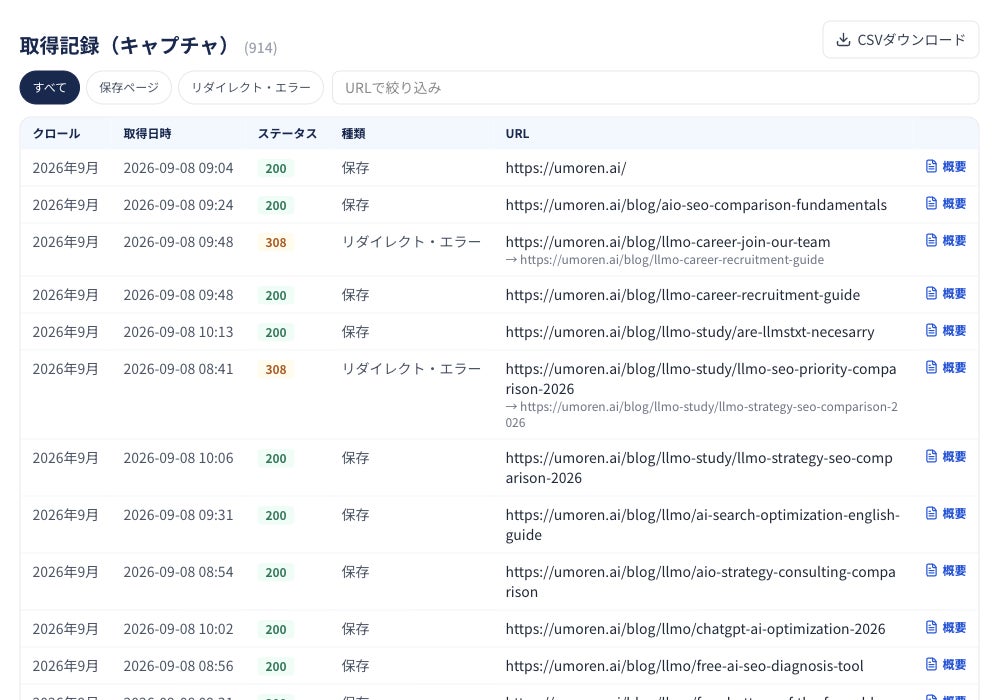
対象サイトについて取得された個別のクロール記録を一覧で確認できます。取得日時、URL、HTTPステータス、保存・リダイレクト・エラーといった情報を表示し、記録を絞り込んだり、CSV形式でダウンロードしたりすることも可能です。
複数のページについて保存状況を確認したい場合や、技術部門と調査結果を共有したい場合にも活用できます。
■ 利用方法:URLを入力するだけの3ステップ
本ツールはブラウザから利用でき、ソフトウェアのインストールは不要です。
STEP 1:URLまたはドメインを入力 確認したいWebページのURLを入力します。ログイン済みの無料アカウントでは、サイト全体やサブドメインを含めた確認も可能です。
STEP 2:Common Crawlのクロール記録を照合 指定された期間のクロールを参照し、保存・リダイレクト・エラーなどの情報を収集します。
STEP 3:診断結果と原因を確認 保存状況を確認し、必要に応じて当時のrobots.txt、ブロックされたレスポンス、保存されたHTMLなどの詳細を調査します。
単一ページのチェックはアカウント登録なしで開始できます。詳細レポートの閲覧には、無料アカウント登録または所定の企業情報の入力が必要な場合があります。
|
▶ AI事前学習データチェッカー(無料) |
■ AI検索対策(LLMO)への活用:事前学習とリアルタイム検索の両面から確認
生成AIが企業やサービスについて回答する際には、モデルの事前学習によって得られた知識と、回答時に外部情報を検索・取得する仕組みの両方が関係します。そのため、AI検索対策を考える際には、少なくとも以下の2つを区別することが重要です。
① 事前学習データの収集元へのアクセス可能性
Common Crawlなどのデータソースに自社の情報が保存されているか、クローラーが適切にコンテンツを取得できているかを確認します。
② リアルタイムAI検索における発見・引用・推薦
ChatGPT検索やPerplexityなどが、質問に応じて自社のWebページを取得し、回答の根拠として利用するか、企業・サービス名を候補として紹介するかを確認します。
Common Crawlへの保存は、特定のAIモデルに学習されたことを保証するものではありません。また、Common Crawlに記録がないことだけをもって、ChatGPT検索などへの表示が不可能と判断することもできません。
Queue株式会社では、こうした異なる段階を分けて把握することが、AI検索での現状分析と改善施策の立案に役立つと考えています。
今回公開した「AI事前学習データチェッカー」に加えて、umoren.aiではChatGPTの検索クエリや情報取得の過程を分析する「ChatGPTクエリファンアウト分析ツール」なども提供しています。
今後もLLMエンジニアリングの知見をもとに、企業がAI検索の仕組みを理解し、データに基づいて改善を進めるための分析環境を提供してまいります。
ChatGPTクエリファンアウト分析ツール:https://umoren.ai/free-tools/chatgpt-query-fanout
ベクトルファンアウト診断ツール:https://umoren.ai/free-tools/vector-fanout-checker
無料ツール一覧:https://umoren.ai/free-tools
■ ツール概要
|
ツール名 |
AI事前学習データチェッカー(Common Crawl) |
|
提供元 |
Queue株式会社/umoren.ai |
|
公開時期 |
2026年10月 |
|
料金 |
無料 |
|
対応言語 |
日本語・英語 |
|
利用条件 |
単一ページの基本チェックはアカウント登録不要。サイト全体・サブドメインを含む確認には無料アカウントが必要です。 |
主な機能:Common Crawlへの保存状況の確認/クロール単位の保存・エラー・リダイレクト分析/2008年以降のクロール履歴/CCBotおよび主要AIボット向けrobots.txtルール確認/Cloudflareなどのブロック原因分析/保存HTMLのプレビュー・ソース確認/取得記録表示・CSV出力
ツールURL:https://umoren.ai/free-tools/common-crawl-checker
■ umoren.aiについて
umoren.aiは、Queue株式会社が提供するAI検索最適化(LLMO・GEO・AIO)サービスです。
LLMエンジニアチームの知見をもとに、ChatGPT、Gemini、Google AI Overviewsなどの生成AI上で、企業やサービスが適切に認識され、引用・推薦される状態を目指して、現状分析から戦略設計、コンテンツ制作・改善、継続的な計測までを支援しています。
また、ChatGPTクエリファンアウト分析ツールをはじめとした無料分析ツールも公開し、AI検索の内部構造や情報取得プロセスを理解するための環境整備にも取り組んでいます。
サービスサイト:https://umoren.ai/
無料相談・お問い合わせ:https://umoren.ai/contact
■ 会社概要
会社名:Queue株式会社
代表者:代表取締役 谷口 太一
所在地:東京都中央区銀座8丁目17-5 THE HUB 銀座 OCT
設立:2024年4月
事業内容:LLMO(AI検索最適化)事業、ChatGPT広告運用支援
会社URL:https://queue-tech.jp/
本件に関するお問い合わせ:https://umoren.ai/contact
すべての画像
