イレブンラボ、音声認識モデル「Scribe v3」「Scribe v3 Live」を発表 録音とリアルタイムの両方で、話者の識別と認識精度を改善。日本語を含む90以上の言語に対応
音声AIリサーチと革新的テクノロジーのグローバルリーダーであるElevenLabs(本社:米国ニューヨーク州、CEO:Mati Staniszewski、以下イレブンラボ)は、2026年11月10日(米国時間)、音声認識(Speech to Text)モデル「Scribe v3」と「Scribe v3 Live」を発表しました。録音済みの音声に向けた「Scribe v3」と、リアルタイムの音声に向けた低遅延版の「Scribe v3 Live」の2つのモデルを、開発者向けの「ElevenAPI」で提供します。「Scribe v3 Live」は、音声・チャットエージェントプラットフォーム『ElevenAgents』でも利用できます。

実際の会話の音声に向けて開発
議事録、音声エージェント、吹き替え、診療記録、放送アーカイブなど、音声を扱うサービスの多くは文字起こしから始まります。文字起こしの誤りはその後の工程にそのまま引き継がれ、後から直すほど手間がかかります。
一方、実際の音声には、会議で複数の人の発言が重なる、通話相手が文の途中で言葉に詰まる、話し手同士が母国語以外で会話する、といった条件が含まれます。「Scribe v3」「Scribe v3 Live」は、こうした条件での正確さを目指して開発したモデルです。
-
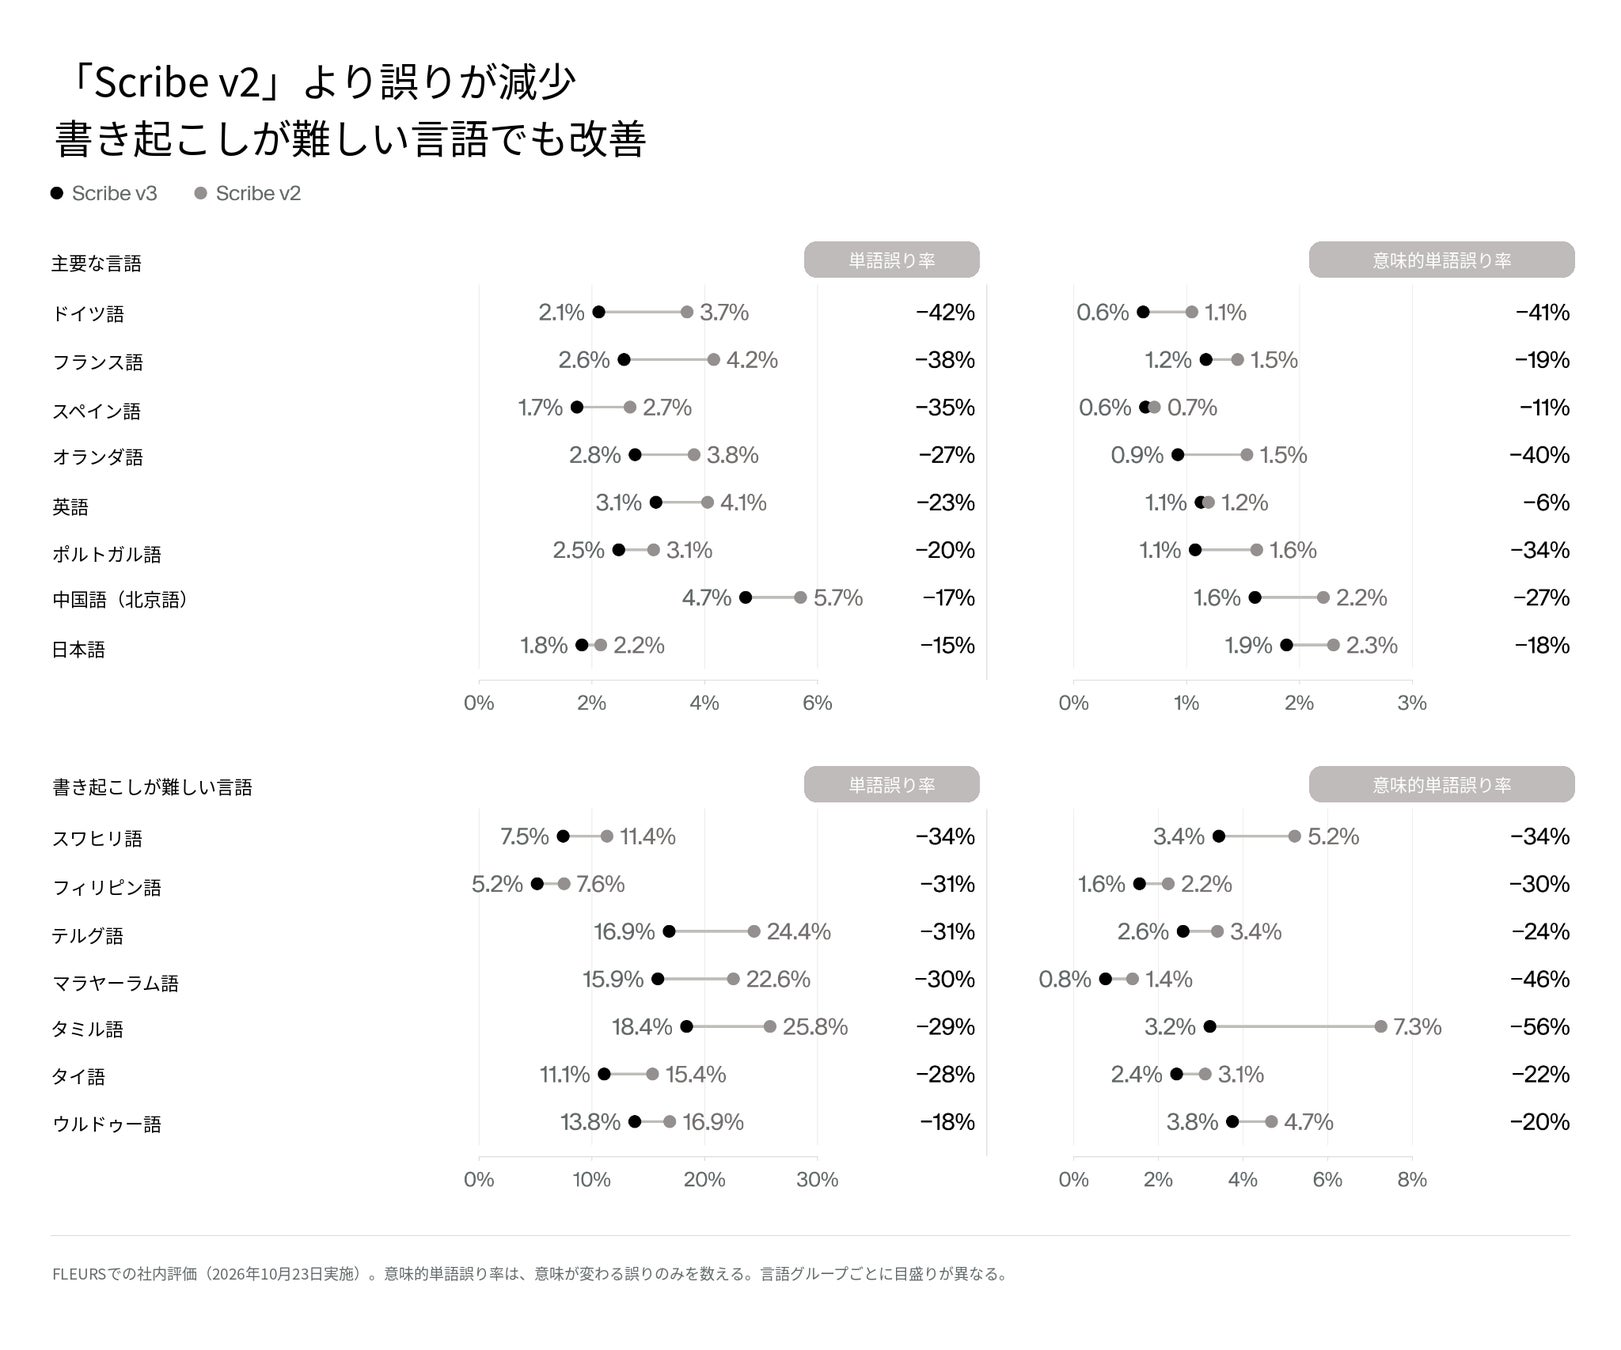
「Scribe v3」(録音済み音声向け):前モデル「Scribe v2」と比べて単語の誤りを27%削減しました(102言語での評価)。「誰が話したか」を判別する話者識別(誰が話したかの判別)でも、当社が評価したモデルの中で最も誤りが少ない結果となりました。
-
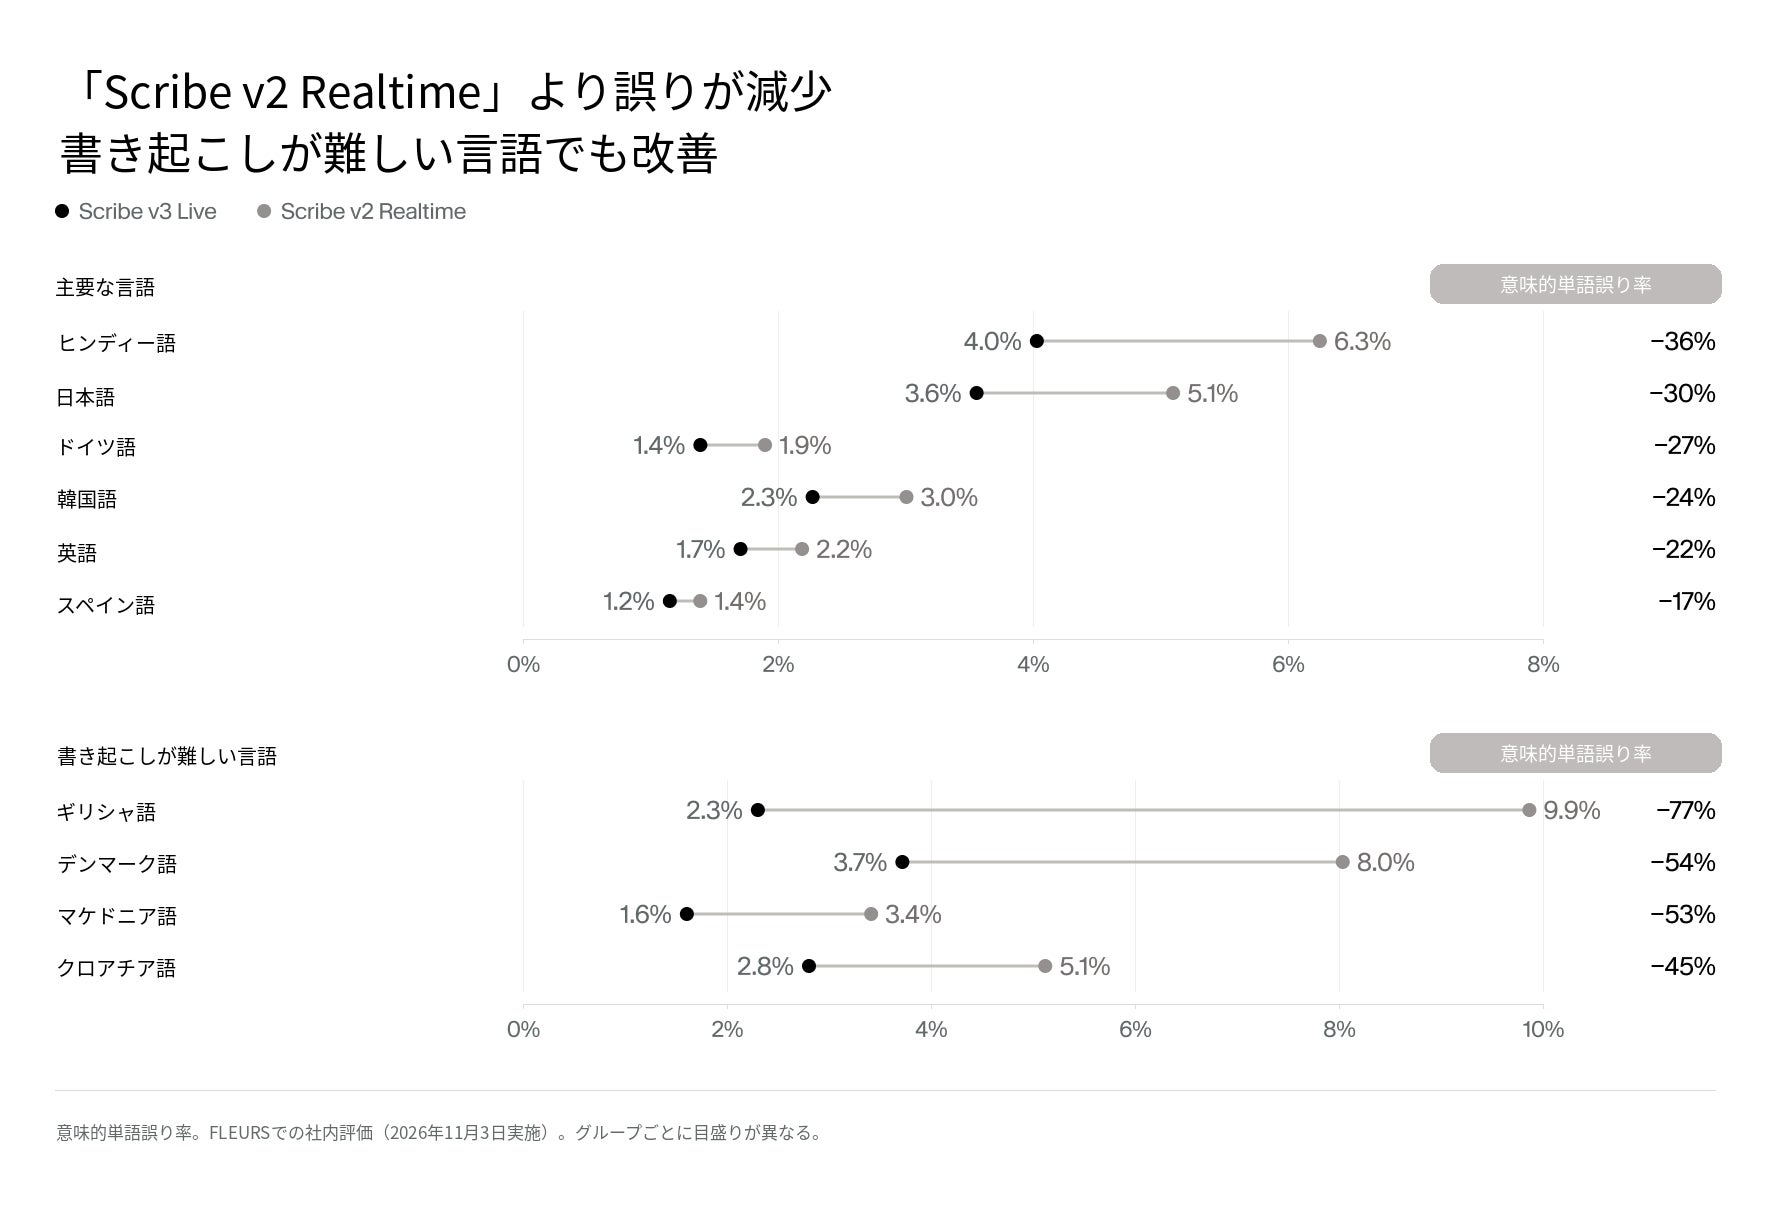
「Scribe v3 Live」(リアルタイム音声向け):前モデル「Scribe v2 Realtime」と比べて誤りを43%削減しました(102言語での評価)。リアルタイムのモデルとして初めて話者識別に対応し、話し終わりの判定(ターン検出)も改善しました。
話者識別とターン検出、出力の調整機能
3人以上の会議でも話者を判別
「Scribe v3」は、3人以上が話す録音で、話者識別の誤りを「Scribe v2」より17%削減しました。「Scribe v3 Live」はリアルタイムで話者を判別します。当社の評価では、話者識別の誤りは、次に良かったリアルタイムのモデルより39%少ない結果となりました。
会話の文脈から話し終わりを判定
音声エージェントが自然に会話するには、相手が話し終えたかどうかを正確に判定する必要があります。無音の長さだけで判定すると、短く設定すれば話の途中で割り込み、長く設定すれば応答が遅くなります。「Scribe v3 Live」は音声に加えて会話の文脈も使って判定するため、番号を読み上げる途中で間を置いても、発話の途中で遮りません。この機能は『ElevenAgents』ですでに使われているもので、今回からAPIでも利用できるようになりました。
言語・用語・表記の調整
「Scribe v3」では、音声に含まれる言語のヒントを複数指定できるほか、数字を数字表記と文字表記のどちらで出力するかを選べます。社名、略語、専門用語など、登場することがわかっている用語を最大1,000語まで登録できるほか、「日付はすべてYYYY-MM-DD形式で書く」のように、表記のルールを自然な文章で指定できます。
「Scribe v3 Live」は、会話の途中で言語が切り替わる場合に対応するマルチリンガルモードを備えています。さらに、一覧として渡すには多すぎる大量の用語を登録しておき、該当しそうな言葉が聞こえたときだけ参照する「キーターム・ライブラリ」も利用できます。
評価結果
当社は、両モデルを前モデルおよびほかの主要な音声認識モデルと同じデータセットで評価しました。多言語の認識精度は、102言語の読み上げ音声で構成されるベンチマーク「FLEURS」の社内版で測定しました。話者識別は、FLEURSでは測れないため(収録された音声の話者が1人のため)、実際の会議、エージェントとの通話、音声メモで構成した16言語の独自データセットで評価しました。このデータセットは近日中にオープンソースとして公開する予定です。
-
「Scribe v3」は、評価した102言語すべてで「Scribe v2」より誤りが減りました。また、当社が評価したほかの録音済みの音声向けのモデルのいずれよりも、単語の誤りが少ない結果となりました。
-
「Scribe v3 Live」は、評価したすべての言語で「Scribe v2 Realtime」より誤りが減りました。また、当社が評価したほかのリアルタイムモデルのいずれよりも、誤り率が低い結果となりました。
導入事例:Eneco
オランダで200万以上の家庭と企業にエネルギーを供給するEnecoは、『ElevenAgents』で稼働している音声エージェントで、提供開始前に「Scribe v3 Live」を試験しました。実際のお客様との通話で、音声エージェントがオランダの郵便番号を1回で正しく認識できた割合が、郵便番号で40%、番地で15%向上しました。
Eneco シニアプロダクトマネージャーのRuud Huigsloot氏は、次のように述べています。「イレブンラボは、Enecoにとって真のパートナーです。同社の導入を現場で支援するエンジニア(フォワード・デプロイド・エンジニア)とともに、音声エージェントのさらなる改善に取り組んでいます。早い段階で大きな成果が出ていることをうれしく思っており、今後の協業も楽しみにしています。」
エンタープライズ向けの機能
「Scribe v3」「Scribe v3 Live」は、処理が終わると音声とテキストをすぐに削除する「Zero Retention Mode」に対応し、SOC 2、ISO 27001、PCI DSS Level 1の認証を取得しています。BAA(Business Associate Agreement)を締結すればHIPAAの対象業務にも利用でき、プライベート環境での導入にも対応しています。
提供方法
「Scribe v3 Live」は『ElevenAgents』で利用できます。また、イレブンラボのアプリでは「Scribe v3」と「Scribe v3 Live」が標準のモデルになりました。
「ElevenAPI」でも両モデルを本日より利用できます。現在「Scribe v2」を利用している場合は、モデルIDを「scribe_v3」または「scribe_v3_live」に変更するだけで切り替えられます。
また、医療機関向けに、診療に関する会話に最適化した「Scribe v3 Live」のバージョンも『ElevenAgents』で提供します。
詳細(英語): https://elevenlabs.io/blog/scribe-v3
日本市場について
日本では、少子高齢化を背景に働き手の不足が進んでいます。リクルートワークス研究所の試算では、2040年に約1,100万人の働き手が不足するとされています。会議の記録やコンタクトセンターでの通話内容の記録など、日々の業務を限られた人員でどう続けるかが、多くの企業の課題になっています。
会議の記録や通話内容の文字起こしはAIが担い、人は内容の確認や判断が必要な対応に時間を使う。正確な音声認識は、こうした役割分担の土台になります。「Scribe v3」「Scribe v3 Live」は日本語を含む90以上の言語に対応しています。日本の企業や開発者の皆さまとともに、音声を活用したサービスの実現に取り組んでまいります。
イレブンラボについて
イレブンラボは、2022年に設立された、テクノロジーとの関わり方を変革するAI研究・プロダクト企業です。企業向けの音声・チャットエージェントプラットフォーム「ElevenAgents」、コンテンツの制作・編集を支援する「ElevenCreative」、開発者がAIオーディオ基盤モデルを利用できる「ElevenAPI」を提供しています。音声合成、音声認識、会話型AIなどを通じて、企業、開発者、クリエイターによる新たなコミュニケーション体験の構築を支援。現在の企業評価額は220億米ドルを超え、プラットフォームは、Fortune 500企業の80%以上を含む数千社に利用されています。
日本語サイト: https://elevenlabs.io/ja
LinkedIn: https://www.linkedin.com/company/elevenlabs-japan/
イレブンラボ 日本語版X(旧Twitter): @ElevenlabsJapan
イレブンラボジャパン公式note: https://note.com/elevenlabs_japan
このプレスリリースには、メディア関係者向けの情報があります
メディアユーザー登録を行うと、企業担当者の連絡先や、イベント・記者会見の情報など様々な特記情報を閲覧できます。※内容はプレスリリースにより異なります。
すべての画像
- 種類
- 商品サービス
- ビジネスカテゴリ
- システム・Webサイト・アプリ開発ネットサービス
- ダウンロード
- プレスリリース素材
このプレスリリース内で使われている画像ファイルがダウンロードできます
